
Biodiversidad
5.771 plantas, 89 millones de registros y una advertencia: el promedio esconde qué especies mapea bien un modelo de distribución
Un preprint de septiembre de 2026 compara modelos clásicos y redes neuronales para mapear 5.771 especies de plantas. Los promedios son casi iguales; lo que cambia es qué especies salen bien paradas. Qué mide SAGE y qué implica para quien usa mapas de distribución.
¿Buscas el trámite y no la noticia? Guías de trámites ambientales, con su norma, su autoridad competente y sus fuentes oficiales.
Dos modelos con casi el mismo puntaje promedio pueden fallar en especies distintas. Esa es la advertencia central de SAGE, un benchmark publicado como preprint el 25 de septiembre de 2026 por equipos de la Universidad de Zúrich, la EPFL, el WSL y la ETH Zúrich (Arens et al., arXiv:2609.31082). Compararon modelos de distribución de especies sobre 5.771 plantas y encontraron que un Random Forest y una red neuronal multiespecie empatan en el promedio, pero no en las especies que mapean mejor.
Para quien usa un mapa de distribución en una línea base, una priorización de áreas o un análisis de conectividad, la pregunta útil no es qué modelo gana, sino para qué especies se puede confiar en el mapa.
Qué es un modelo de distribución y dónde se tuerce
Un modelo de distribución de especies (SDM, por species distribution model) enlaza dónde se ha registrado una especie con las condiciones ambientales de esos sitios, y proyecta dónde más podría vivir. Se usa para priorizar áreas de protección, anticipar efectos del clima, manejar especies invasoras o planear infraestructura, según los propios autores.
El problema está en los datos. La mayoría de los registros globales son de "solo presencia" y vienen de plataformas de ciencia comunitaria: saben dónde alguien vio la especie, no dónde la buscó y no la encontró. El artículo, apoyándose en Hughes et al. (2021), recuerda que menos del 7 % de las celdas de 5 km del planeta tienen algún registro, y que el muestreo se concentra donde hay carreteras y gente. Si una especie casi no aparece, el modelo no sabe si es rara o si nadie la miró.
Esa es la lección práctica para quien baje datos de GBIF (hay una guía en GBIF para consultores): el registro mide el esfuerzo de observación tanto como la presencia de la especie.
Cómo SAGE separa las especies fáciles de las difíciles
El benchmark junta dos fuentes independientes. Para entrenar, 89.768.872 registros de GBIF. Para evaluar, 53.336 parcelas de vegetación de sPlotOpen con listas completas de especies, donde sí se sabe qué hay y qué no. Cada punto trae 52 variables ambientales (clima, suelo, topografía y huella humana).
La idea nueva es describir cada especie con dos propiedades y evaluar por grupos, no solo en promedio:
| Propiedad | Qué mide | Se lee así |
|---|---|---|
| Esfuerzo de muestreo | Proporción de celdas dentro del rango de la especie que tienen algún registro de cualquier especie | ¿Se ha mirado el territorio donde vive? |
| Prevalencia relativa | De las celdas visitadas dentro del rango, proporción donde se registró esa especie | Donde se mira, ¿se la encuentra? |
Se parte cada propiedad por la mediana y salen cuatro grupos: muestreo escaso o denso, y especie poco o muy registrada. Los autores aclaran que una prevalencia baja puede significar rareza real o que los observadores la ignoran, y que con los registros solos no se distingue.
Qué encontraron: un empate con matices
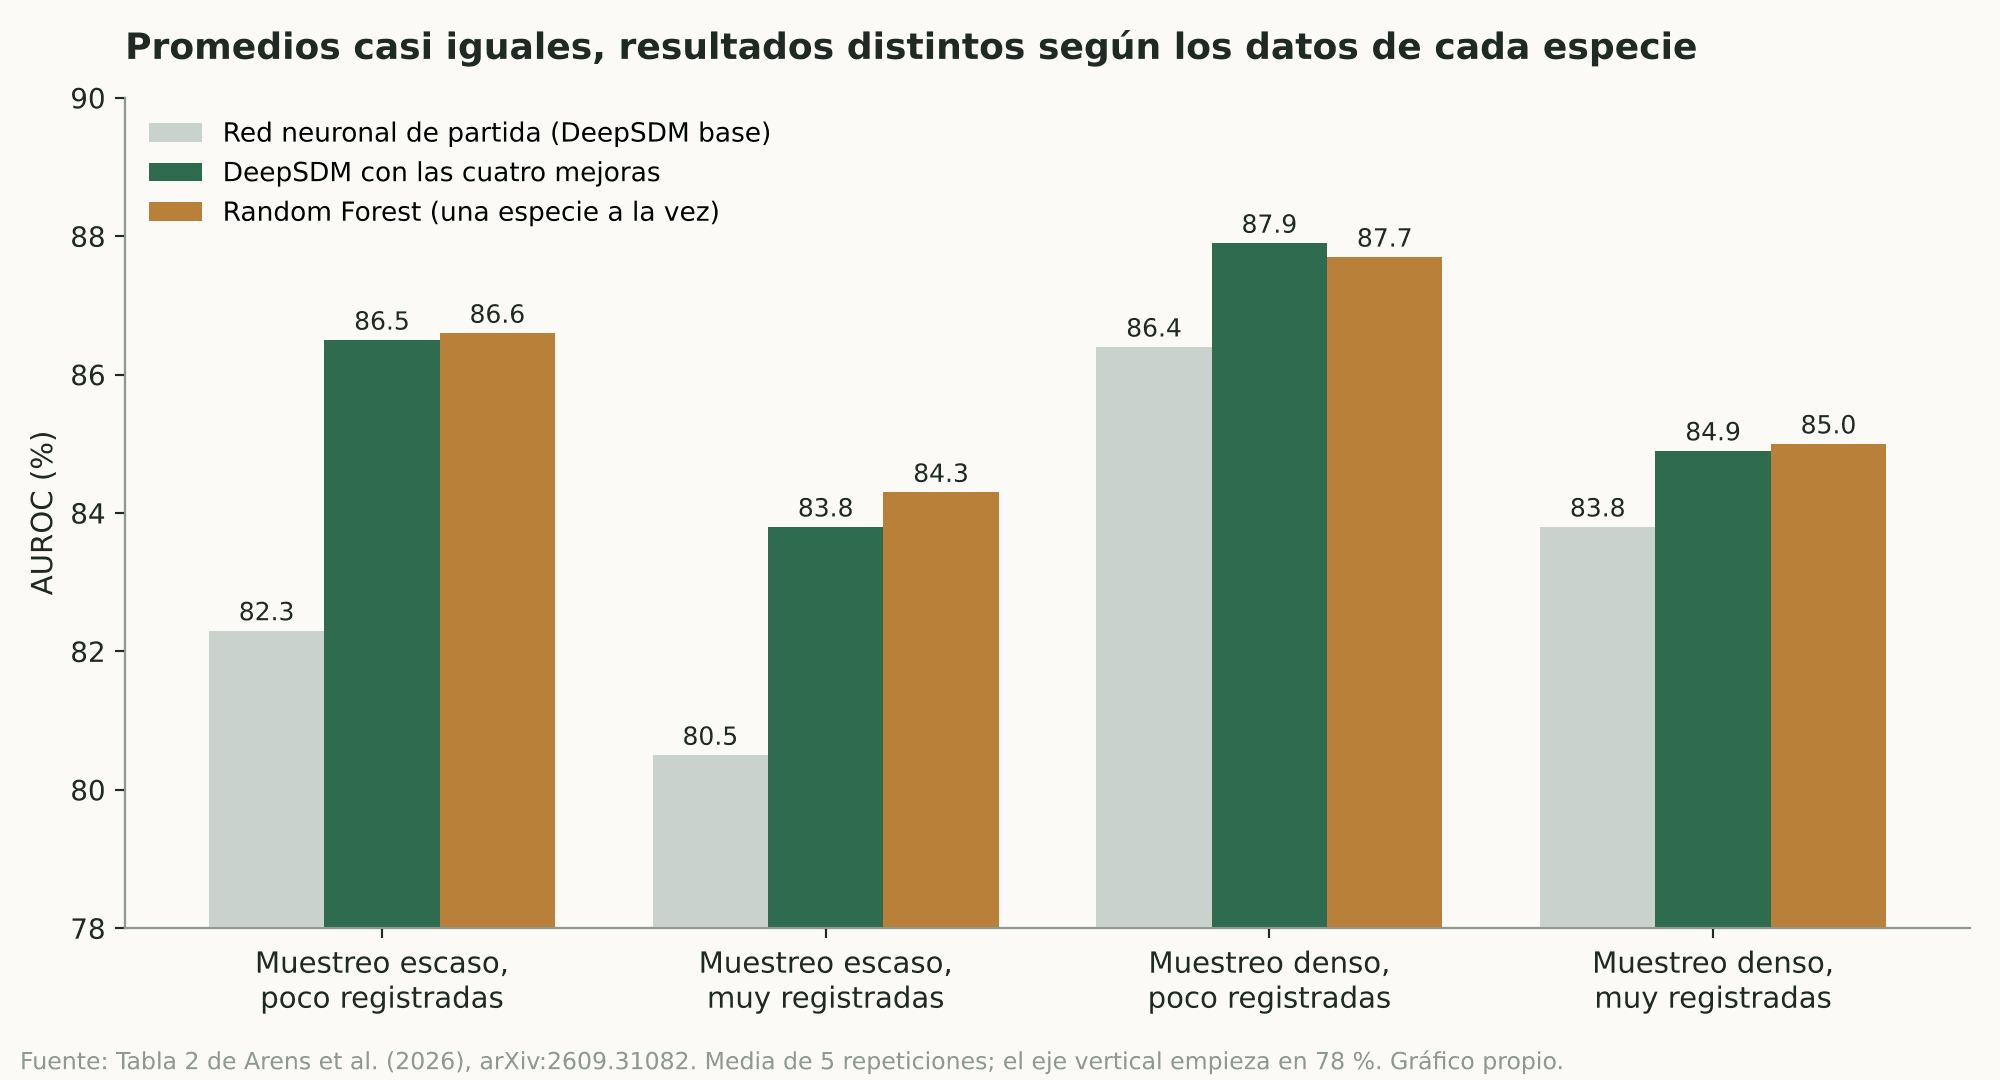
Con la métrica AUROC (qué tan bien el modelo ordena sitios con y sin la especie), el Random Forest, que ajusta un modelo por especie, obtiene 85,9 % en promedio y la red multiespecie optimizada 85,8 %. Los otros métodos clásicos quedan abajo: BRT 85,2 %, MaxEnt 84,5 %, GLM 84,0 % y GAM 83,8 %.
Los autores no ven un ganador, y lo dicen con cuidado:
- La red mejora para las especies poco registradas. El resumen del artículo dice que las redes neuronales superan a los modelos por especie en las poco registradas y no tienen ventaja consistente en las bien muestreadas. En la tabla por cuadrantes las diferencias son de décimas de punto, y el patrón se ve con más claridad en los mapas de diferencias por grupo del artículo.
- El Random Forest manda donde casi no se ha muestreado. A escala geográfica, la red rinde mejor en regiones bien muestreadas y el Random Forest lidera en los trópicos submuestreados.
- Un ejemplo sobre Colombia. Entre cuatro especies ilustrativas, Azorella pedunculata, nativa de Colombia y Ecuador y con muestreo escaso en su rango, salió mejor parada con la red multiespecie. Los autores advierten que son ejemplos, no casos representativos.
Lo que más mejora a una red: preparar los datos, no hacerla más grande
La red de partida obtuvo 83,3 %. Con cuatro cambios llegó a 85,8 %, una ganancia total de 2,5 puntos. El orden de importancia es la parte más útil del estudio:
- Pérdida ponderada con fondo del grupo objetivo: usar como "ausencias" los puntos donde se registraron otras especies, en vez de puntos al azar, subió el puntaje en más de cinco puntos en esa prueba. Es la mejora individual más grande.
- Agregar registros por celda de 1 km: quita la repetición de datos en sitios muy visitados.
- Submuestrear a 1.000 muestras por especie: el mejor resultado se logró con 1,6 millones de muestras de 4,1 millones disponibles en la versión agregada.
- Cambiar la arquitectura: una red más compleja aportó muy poco (0,2 a 0,3 puntos).
La conclusión de los autores es que, con variables ambientales tabulares, "cómo se preparan y ponderan los datos importa más que la elección de la red". Combinando agregación y submuestreo lograron resultados equivalentes con menos del 6 % de las muestras del conjunto completo, lo que equivale a prácticas de adelgazamiento espacial (spatial thinning) conocidas desde hace años.
Lo que no demuestra
Es un preprint, sin revisión de pares, y tiene límites que los propios autores señalan:
- Solo plantas, y con parcelas de vegetación que cubren mejor las zonas templadas que las tropicales, incluso después de rebalancear.
- Los rangos de cada especie son gruesos: salen de listas de países donde es nativa, lo que puede sobreestimar o subestimar su extensión.
- Las parcelas son pequeñas frente al píxel. Su mediana es de 100 m² y el modelo trabaja a 1 km². Según el texto, esto cambia los puntajes absolutos pero no el orden de los modelos.
- El AUROC tiene sus propios sesgos, y comparar puntajes entre especies puede engañar; lo informativo es la diferencia entre modelos.
Datos, código y modelos están publicados en la página del proyecto, con los conjuntos en Zenodo, así que cualquiera puede repetir la comparación.
Qué significa para quien usa mapas de distribución
Lo que sigue es análisis propio, no conclusiones del artículo.
- Pide el puntaje por especie, no el promedio. Un informe que reporta "AUROC de 0,85" sin decir para cuáles especies no dice si el mapa sirve para las que importan, que suelen ser las raras.
- Mira cuánto se ha muestreado el rango antes de confiar. Si el territorio apenas tiene registros, el mapa refleja sobre todo qué tan accesible es.
- Un modelo clásico bien hecho sigue siendo una referencia dura de superar. La red multiespecie solo igualó al Random Forest tras cuatro ajustes cuidadosos de datos.
- Falta evidencia para el trópico. Justo donde el muestreo es más escaso, el modelo por especie ganó, y el benchmark solo cubre plantas.
Una conclusión
El mejor resultado de SAGE no es un modelo, es una forma de evaluar: preguntar con qué datos cuenta cada especie antes de comparar puntajes. Mientras los registros sigan concentrados donde hay caminos, un promedio alto puede esconder las especies que más necesitan un buen mapa.
Portada: botánica tomando notas en un bosque nublado andino. Imagen generada con IA (openai/gpt-image-2).
Juan Felipe Romero
Ecólogo
Soy ecólogo con posgrado en Administración Ambiental de Zonas Costeras y Máster en Restauración Ecológica, con más de 18 años de experiencia en planificación, gestión y desarrollo de soluciones tecnológicas ambientales.
Este artículo se redactó con apoyo de inteligencia artificial, bajo dirección editorial de Juan Felipe Romero.
Sigue leyendo
Biodiversidad
423 estudios, un mismo mensaje: perder especies recorta los servicios de los ecosistemas más de lo que se creía
Juan Felipe Romero · 12 de octubre de 2026
Monitoreo
Fototrampeo: cómo diseñar el muestreo y analizar los datos de las cámaras trampa
Juan Felipe Romero · 12 de octubre de 2026
Monitoreo
¿Cuántas cámaras trampa hacen falta? Una simulación muestra que la respuesta va de 10 a 600 sitios
Juan Felipe Romero · 2 de octubre de 2026Con Biopaisaje
La línea base del territorio, sin armarla a mano
Caracterización física, biótica y socioeconómica con cinco métodos de conectividad ecológica y cartografía entregable.
Boletín semanal
¿Qué cambió esta semana en la norma ambiental?
Cada lunes, un correo con las resoluciones y decretos ambientales que salieron esa semana en Colombia: qué exige cada uno, desde cuándo aplica y el enlace al texto oficial.